
Nachbesprechung eines VMware-Ausfalls: Auswirkungen von der VM über das Rack bis zur Stromversorgung
Veröffentlicht am 8. Januar 2026,
by

Ausfälle beschränken sich selten auf eine einzelne Ebene, sondern breiten sich über virtuelle, physische und Stromversorgungsinfrastrukturen aus. Bei einem VMware- Vorfall besteht die Herausforderung nicht nur darin, den Fehler zu identifizieren, sondern auch seine Auswirkungen auf vernetzte Systeme zu verstehen. In diesem Blogbeitrag untersuchen wir ein praxisnahes Szenario und zeigen, wie die DCIM- Plattform (Data Center Infrastructure Management) von Nlyte umfassende Transparenz bietet und die Beziehungen von VMs zu Hosts, Racks, PDUs und der gesamten Stromversorgungskette abbildet. Durch die Aufdeckung der Ursache und ihrer Folgewirkungen verkürzt Nlyte die mittlere Reparaturzeit (MTTR) und unterstützt Teams bei der schnellen und zuverlässigen Wiederherstellung des Betriebs.
Warum Ausfallanalysen wichtig sind
Moderne Rechenzentren sind komplex. Für Virtualisierungsverantwortliche, Site Reliability Engineers (SREs) und Incident Commander kann ein einzelner Ausfall weitreichende Folgen für virtuelle und physische Systeme haben. In solchen Fällen sind die Auswirkungen unmittelbar und kostspielig.
Herkömmliche Überwachungstools beschränken sich oft auf die VM- oder Host-Ebene. Dadurch bleiben Teams hinsichtlich tieferliegender Abhängigkeiten innerhalb des Stacks im Dunkeln. Dieser Mangel an Transparenz verlangsamt die Reaktionszeiten und erhöht die Ausfallzeiten.
Hier kommt die VMware DCIM- Integration ins Spiel. Durch die Verbindung von VMware-Umgebungen mit DCIM-Plattformen erhalten Teams einen vollständigen Überblick über ihre Infrastruktur. Die fortschrittliche Abhängigkeitsabbildung stellt sicher, dass jede Ebene – von virtuellen Maschinen bis hin zu physischen Assets – überwacht und verknüpft wird.
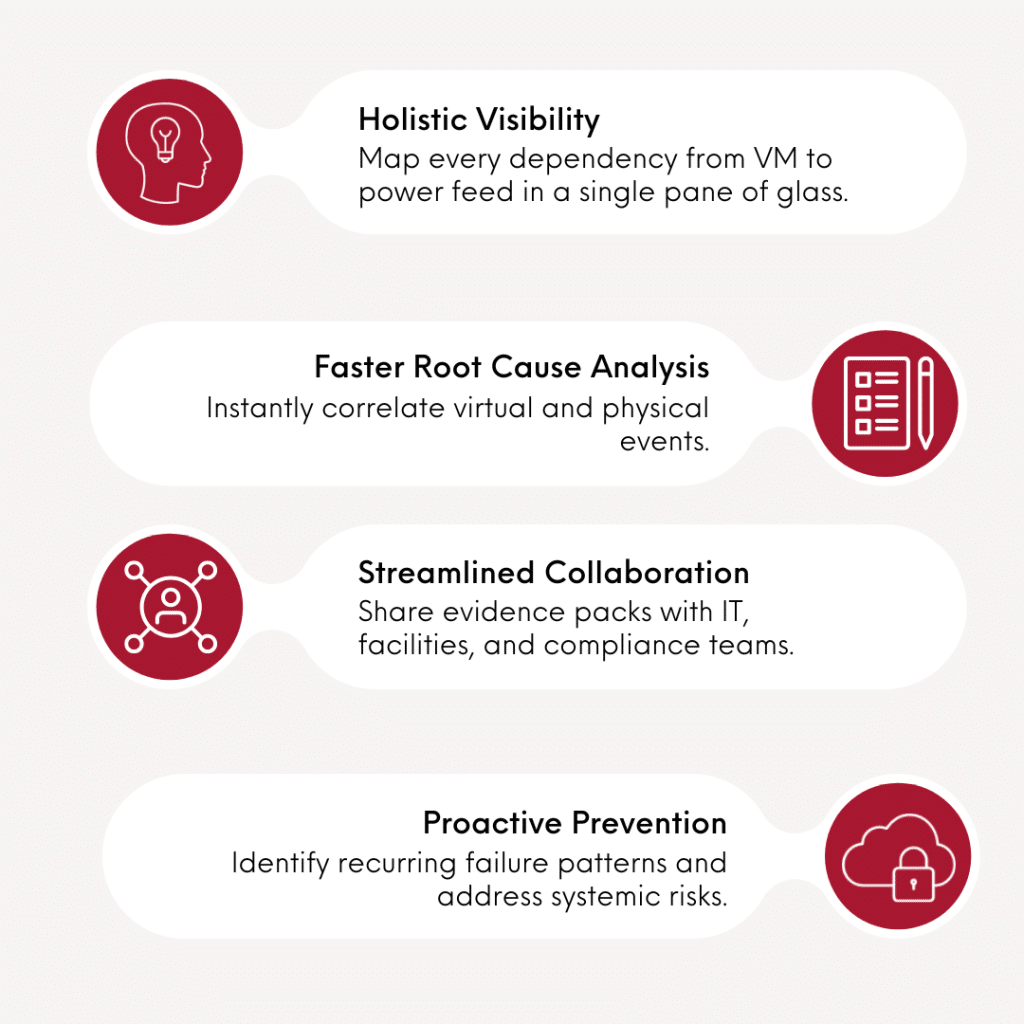
Durch diese Integration können Unternehmen schnell die Ursachen von Störungen identifizieren, Ausfallzeiten reduzieren und die mittlere Reparaturzeit (MTTR) verbessern. Sie ermöglicht außerdem eine vorausschauende Planung, eine bessere Ressourcenzuweisung und eine höhere Widerstandsfähigkeit gegenüber Folgeausfällen.
Ein realistisches VMware-Ausfallszenario
Stellen Sie sich vor, eine geschäftskritische Anwendung fällt plötzlich aus. Erste Untersuchungen deuten auf einen VM-Fehler hin, doch die eigentliche Ursache ist nicht sofort ersichtlich. Lag es an einem Host-Problem? An einem Stromausfall im Rack? Oder an etwas weiter vorgelagert in der Stromversorgungskette?
Schritt 1: Virtuelle Maschine zuordnen
Beginnen Sie mit der virtuellen Ebene. Identifizieren Sie die betroffene VM umgehend. Die Integration von Nlyte ermöglicht die sofortige Transparenz der VM-Platzierung und ihrer Beziehungen. Diese Abhängigkeitsanalyse stellt sicher, dass Teams genau wissen, wo das Problem seinen Ursprung hat.
Schritt 2: Identifizieren Sie den Host
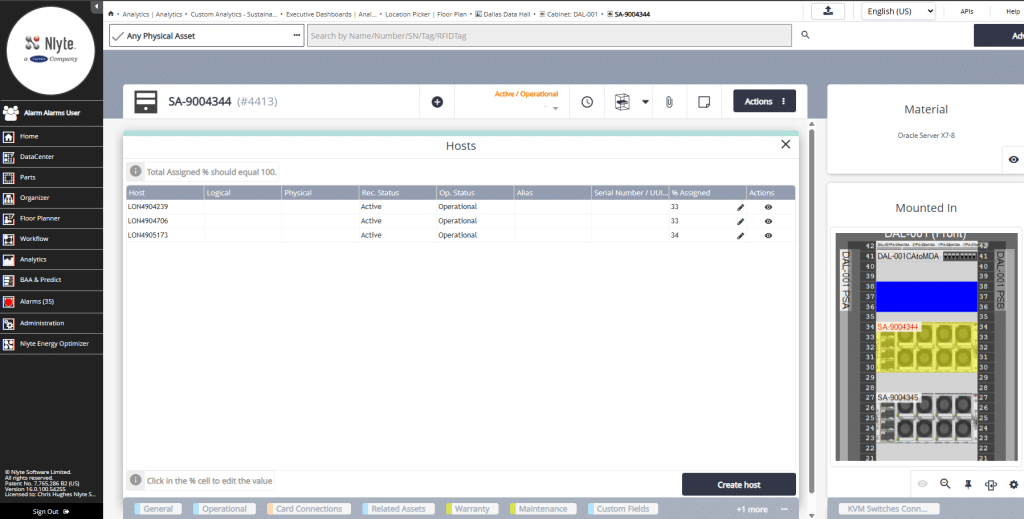
Verfolgen Sie als Nächstes die VM zu ihrem ESXi-Host. Das Verständnis dieser Verbindung ist entscheidend, da Hostausfälle häufig mehrere virtuelle Maschinen betreffen. Eine schnelle Identifizierung beschleunigt die Fehlersuche und hält die mittlere Reparaturzeit (MTTR) kurz.
Schritt 3: Das Rack lokalisieren
Nachdem der Host lokalisiert wurde, wird die physische Schicht untersucht. Die DCIM-Plattform von Nlyte ermittelt das genaue Rack, in dem sich der Host befindet. Dieser Schritt hilft festzustellen, ob es sich um einen isolierten Ausfall oder um ein größeres Infrastrukturproblem handelt.
Schritt 4: PDU lokalisieren
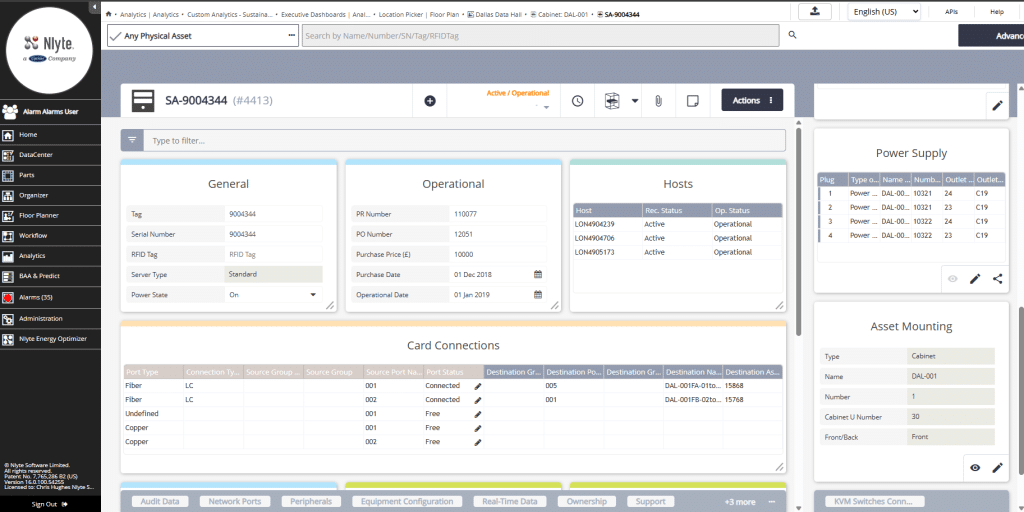
Verfolgen Sie die Verbindungen vom Rack bis zur angeschlossenen Stromverteilungseinheit (PDU). Diese Zuordnung ist unerlässlich, um Stromabhängigkeiten zu beurteilen und potenzielle Hardwarerisiken zu identifizieren.
Schritt 5: Analysiere die Machtkette
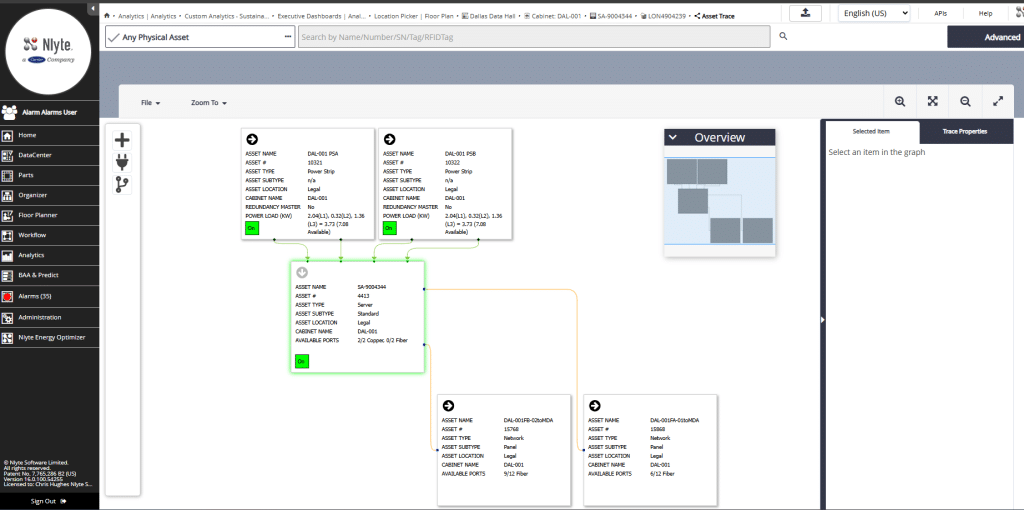
Abschließend sollten Sie die gesamte Stromversorgungskette analysieren. Nlyte bietet Echtzeitüberwachung und historische Telemetriedaten für PDUs und vorgelagerte Leitungen. Bei einer Leistungsschalterauslösung oder Spannungsanomalie wird dies sofort mit der betroffenen virtuellen Maschine und dem Host korreliert. Diese umfassende Übersicht deckt die Ursachen auf und verbessert die Genauigkeit der Störungsanalyse.
Warum Dependency Mapping die MTTR beschleunigt
Probieren Sie die Demo zur Abhängigkeitszuordnung aus.
Sind Sie bereit zu sehen, wie die VMware DCIM-Integration von Nlyte Ihre Reaktion auf Störungen verändern kann?
Gehen Sie den nächsten Schritt hin zu einer schnelleren Ursachenanalyse und einer verkürzten mittleren Reparaturzeit.
Fordern Sie noch heute eine Demo von einem Nlyte-Experten an und erhalten Sie eine personalisierte Live-Demo. Erfahren Sie, wie fortschrittliches Abhängigkeitsmapping und Transparenz der Stromversorgungskette Ihre Rechenzentrumsabläufe optimieren können. > Demo anfordern | Nlyte
