
Erreichen von Verfügbarkeit im Edge-Rechenzentrum durch Ausfallsicherheit
Veröffentlicht am 11. Juli 2025,
by

Erreichen von Verfügbarkeit im Edge-Rechenzentrum durch Ausfallsicherheit
Da Edge Computing zu einem Eckpfeiler der digitalen Infrastruktur wird, ist die Gewährleistung hoher Verfügbarkeit in einem verteilten Netzwerk von Edge-Rechenzentren wichtiger denn je. Diese Einrichtungen arbeiten häufig in abgelegenen oder unbemannten Umgebungen und unterstützen latenzempfindliche Anwendungen wie autonome Fahrzeuge, Smart Cities und Echtzeitanalysen. In diesem Kontext ist die Verfügbarkeit von Edge-Rechenzentren nicht nur eine Leistungskennzahl, sondern eine geschäftliche Notwendigkeit.
Um dieser Herausforderung zu begegnen, setzen Unternehmen auf eine Kombination aus Industriestandards und innovativen Architekturstrategien. Das Tier-Klassifizierungssystem des Uptime Institute bietet ein grundlegendes Rahmenwerk, während sich ein neuerer Ansatz – gemischte Resilienz – als Best Practice für ein ausgewogenes Verhältnis von Kosten, Komplexität und Zuverlässigkeit etabliert.
Lassen Sie uns untersuchen, wie diese Strategien zusammenwirken, um einen unterbrechungsfreien Betrieb am Netzwerkrand zu gewährleisten.
Die Tier-Standards des Uptime Institute verstehen
Das Tier-Klassifizierungssystem des Uptime Institute gilt weithin als globaler Maßstab für die Zuverlässigkeit von Rechenzentren. Es definiert vier Stufen der Infrastrukturresilienz:
| Tier-Level | Jährliche Ausfallzeit | Redundanz | Traditioneller Kunde |
| Stufe I | <28.8 Stunden | Keine Präsentation | Kleinunternehmen, Entwicklungslabore |
| Stufe II | <22 Stunden | Teilleistung und Kühlung (N+1 Komponenten) |
Kleine bis mittlere Unternehmen |
| Stufe III | <1.6 Stunden | Gleichzeitig wartbar (N+1) | Wachsende und große Unternehmen |
| Stufe IV | <26.3 Minuten | Fehlertolerant (2N oder 2N+1) | Großunternehmen, Regierung, internationale Wirtschaft |
- Stufe IGrundlegende Kapazität mit begrenzter Redundanz. Geeignet für nicht kritische Anwendungen.
- Stufe II: Redundante Kapazitätskomponenten (N+1) für verbesserte Fehlertoleranz.
- Stufe IIIGleichzeitige Wartbarkeit ermöglicht es, dass Systeme während der Wartung online bleiben.
- Stufe IVFehlertolerante Infrastruktur mit vollständiger Redundanz (2N), die in der Lage ist, mehrere Ausfälle zu überstehen.
Tier IV bietet zwar die höchste Verfügbarkeit, ist aber auch mit erheblichen Investitions- und Betriebskosten verbunden. Bei Edge-Bereitstellungen – wo Hunderte oder Tausende von Standorten erforderlich sein können – ist der Aufbau jedes einzelnen Standorts nach Tier-IV-Standards oft nicht praktikabel.
Hier kommt die gemischte Resilienz ins Spiel.
Was ist gemischte Resilienz?
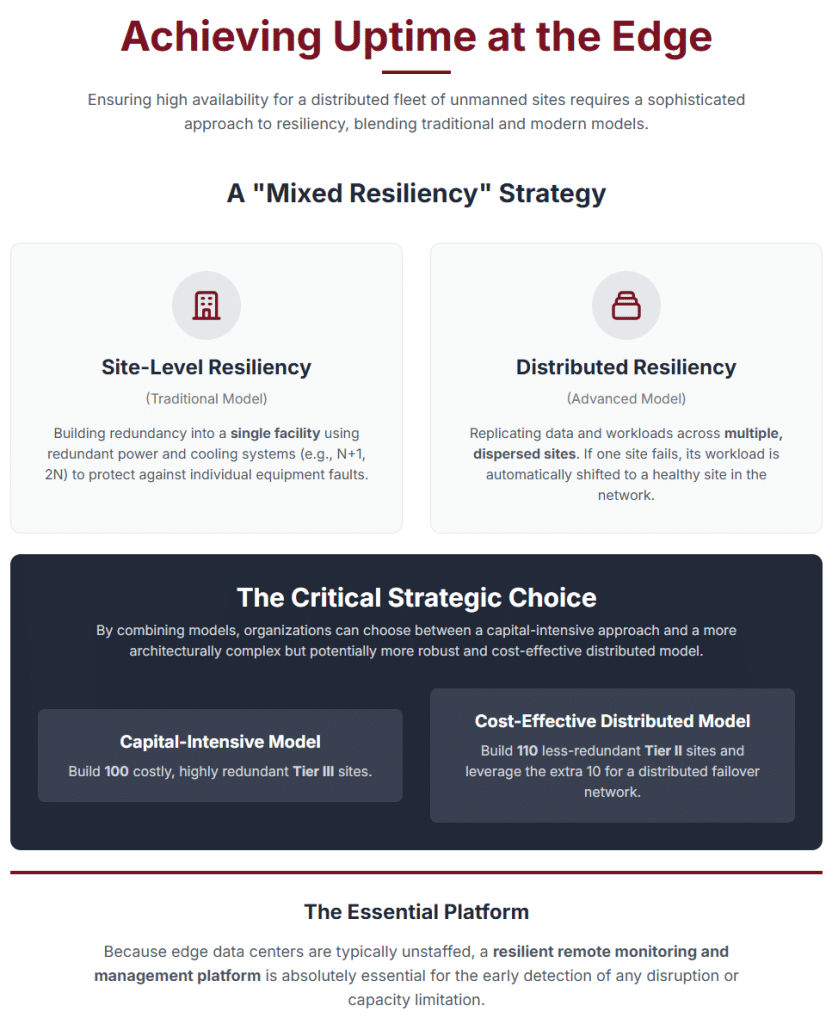
Gemischte Resilienz ist ein strategischer Ansatz, der zwei Modelle der Fehlertoleranz miteinander verbindet:
| Resilienzmodell | Beschreibung | Am besten geeignet, | Wichtige Überlegung |
| Standortebene | Redundante Komponenten (Stromversorgung, Kühlung) innerhalb eines einzigen Standorts. | Schutz vor dem Ausfall einzelner Geräte. | Höhere Kapitalkosten pro Standort für höhere Stufen. |
| Verteilt | Daten/Workloads werden zur Ausfallsicherung über mehrere Standorte repliziert. | Schutz vor vollständigem Verlust des Geländes (Katastrophe, Sabotage). | Erfordert ausgefeilte Software, ein komplexes Netzwerk und eine ausgefeilte Orchestrierung. |
| Kastenwagen/Passagier | Kombination von standortbezogener und verteilter Resilienz. | Hohe Verfügbarkeit kosteneffektiv in großem Umfang erreichen. | Bringt die Investitionskosten pro Standort mit der architektonischen Komplexität in Einklang. |
Resilienz auf Standortebene
Dies ist das traditionelle Modell zum Aufbau von Redundanz in einer einzelnen Anlage. Es beinhaltet den Einsatz von Backup-Systemen für Stromversorgung und Kühlung – beispielsweise in N+1- oder 2N-Konfigurationen –, um sich vor Geräteausfällen zu schützen. Dieses Modell ist unerlässlich, um die Verfügbarkeit an jedem einzelnen Standort zu gewährleisten.
Allerdings kann die Resilienz auf Standortebene allein teuer sein und lässt sich möglicherweise nicht effizient auf ein großes Edge-Netzwerk skalieren.
Verteilte Resilienz
Verteilte Ausfallsicherheit verfolgt einen umfassenderen, netzwerkbasierten Ansatz. Anstatt sich ausschließlich auf Hardware-Redundanz innerhalb eines einzelnen Standorts zu verlassen, repliziert dieses Modell Daten und Anwendungsworkloads über mehrere geografisch verteilte Edge-Standorte hinweg.
Fällt ein Standort aufgrund eines Stromausfalls, einer Naturkatastrophe oder eines Cyberangriffs aus, kann seine Arbeitslast automatisch auf einen anderen, funktionstüchtigen Standort im Netzwerk verlagert werden. Dies gewährleistet einen unterbrechungsfreien Betrieb, ohne dass jeder Standort nach dem höchsten Tier-Standard ausgebaut werden muss.
Kosten und Verfügbarkeit in Einklang bringen
Die wahre Stärke von gemischter Ausfallsicherheit liegt in ihrer Fähigkeit, Kosten und Verfügbarkeit gleichermaßen zu optimieren. Anstatt beispielsweise 100 hochredundante Tier-III-Edge-Standorte einzusetzen, könnte ein Unternehmen 110 kostengünstigere Tier-II-Standorte wählen. Die zusätzlichen 10 Standorte dienen als Failover-Kapazität und ermöglichen so verteilte Ausfallsicherheit, ohne dass an jedem Standort vollständige Redundanz erforderlich ist.
Dieser Ansatz bietet mehrere Vorteile:
- Geringere InvestitionsausgabenWeniger Redundanz pro Standort bedeutet geringere Vorlaufkosten.
- Größere Skalierbarkeit: Einfachere Bereitstellung und Verwaltung einer größeren Anzahl von Standorten.
- Verbesserte FehlertoleranzGeografische Diversifizierung verringert das Risiko regionaler Ausfälle.
Durch die Kombination von standortbezogener und verteilter Ausfallsicherheit können Unternehmen eine hohe Verfügbarkeit ihrer Edge-Rechenzentren erreichen , ohne diese übermäßig zu dimensionieren.
Die Rolle der Fernüberwachung und -verwaltung
Da Edge-Rechenzentren in der Regel unbemannt sind, hängt die Aufrechterhaltung der Verfügbarkeit auch von robusten Systemen für Fernüberwachung und -verwaltung (RMM) ab. Diese Plattformen bieten Echtzeit-Einblicke in den Zustand der Infrastruktur und ermöglichen die frühzeitige Erkennung von Problemen wie beispielsweise:
- Stromanomalien
- Kühlungsausfälle
- Netzwerkstörungen
- Hardwareverschlechterung
Moderne RMM-Tools können zudem Reaktionen automatisieren, beispielsweise das Auslösen von Failover-Protokollen oder das Entsenden von Wartungsteams. Dieser proaktive Ansatz ist unerlässlich, um die Servicekontinuität in einem verteilten Edge-Netzwerk aufrechtzuerhalten.
Anwendungsbeispiele gemischter Resilienz in der Praxis
Gemischte Resilienz wird bereits in Branchen eingesetzt, in denen die Verfügbarkeit geschäftskritisch ist:
- TelekommunikationNetzbetreiber nutzen verteilte Edge-Standorte zur Unterstützung von 5G-Netzen und gewährleisten so auch bei lokalen Ausfällen einen Dienst mit geringer Latenz.
- GesundheitswesenKrankenhäuser und Kliniken setzen auf Edge-Computing für Echtzeitdiagnostik und Patientenüberwachung, wobei Ausfallsysteme eine kontinuierliche Versorgung gewährleisten.
- Einzelhandel: Die verteilte Edge-Infrastruktur unterstützt Kassensysteme und die Bestandsverwaltung und minimiert so Ausfallzeiten während der Stoßzeiten im Einzelhandel.
- IndustrieIntelligente Fabriken nutzen Edge-Rechenzentren zur Steuerung von Robotik und Automatisierung, wobei die verteilte Ausfallsicherheit eine unterbrechungsfreie Produktion gewährleistet.
In jedem Fall gewährleistet die Kombination aus Tier-basiertem Design und Netzwerkredundanz die für kritische Vorgänge erforderliche Verfügbarkeit.
Ausblick: Die Zukunft der Edge-Verfügbarkeit
Mit dem zunehmenden Wachstum von Edge Computing wird die Bedeutung einer robusten und skalierbaren Infrastruktur weiter steigen. Neue Technologien wie KI-gestützte Überwachung, vorausschauende Wartung und autonome Ausfallsicherung werden die Verfügbarkeit von Edge-Rechenzentren zusätzlich verbessern.
Organisationen, die heute auf gemischte Resilienz setzen, werden besser gerüstet sein, um den Anforderungen der digitalen Wirtschaft von morgen gerecht zu werden – und zuverlässige Echtzeitdienste dort bereitzustellen, wo sie benötigt werden.
Fazit
Um eine hohe Verfügbarkeit von Edge-Rechenzentren zu gewährleisten, reicht der Bau robuster Anlagen allein nicht aus – es bedarf einer strategischen Kombination aus Architekturdesign, operativer Intelligenz und netzwerkweiter Koordination. Durch die Anwendung von Tier-Standards und die Nutzung gemischter Resilienzmodelle können Unternehmen eine Edge-Infrastruktur aufbauen, die nicht nur zuverlässig, sondern auch skalierbar und kosteneffizient ist.
Ob Sie Ihre erste Edge-Implementierung planen oder ein bestehendes Netzwerk optimieren möchten: Jetzt ist der richtige Zeitpunkt, Ihre Strategie für Ausfallsicherheit zu überdenken. Die Edge ist da – und sie muss online bleiben.

Fordern Sie noch heute eine Demo an