
Análisis posterior a una interrupción de VMware: Rastreo del impacto desde la máquina virtual hasta el rack y la alimentación eléctrica.
Publicado el 8 de enero de 2026,
by

Las interrupciones rara vez se limitan a una sola capa; se propagan por la infraestructura virtual, física y eléctrica. Cuando ocurre un incidente de VMware , el desafío no es solo identificar la falla, sino comprender cómo afecta a los sistemas interconectados. En este blog, exploraremos un escenario real y demostraremos cómo la plataforma de administración de infraestructura de centro de datos (DCIM) de Nlyte proporciona visibilidad integral, mapeando las relaciones desde la máquina virtual hasta el host, el rack, la PDU y toda la cadena de suministro eléctrico. Al revelar la causa raíz y sus efectos en cascada, Nlyte acelera el tiempo medio de reparación (MTTR) y ayuda a los equipos a restablecer el servicio de forma rápida y segura.
Por qué son importantes los análisis posteriores a las interrupciones del servicio
Los centros de datos actuales son complejos. Para los responsables de virtualización, los ingenieros de confiabilidad de sitios (SRE) y los coordinadores de incidentes, una sola interrupción puede tener repercusiones en las capas virtuales y físicas. Cuando esto sucede, el impacto es inmediato y costoso.
Las herramientas de monitorización tradicionales suelen limitarse al nivel de la máquina virtual o del host. Como resultado, los equipos desconocen las dependencias más profundas dentro de la infraestructura. Esta falta de visibilidad ralentiza los tiempos de respuesta y aumenta el tiempo de inactividad.
Aquí es donde entra en juego la integración de VMware DCIM . Al conectar los entornos VMware con las plataformas DCIM , los equipos obtienen una visión completa de su infraestructura. El mapeo avanzado de dependencias garantiza que cada capa, desde las máquinas virtuales hasta los activos físicos, se supervise y se conecte.
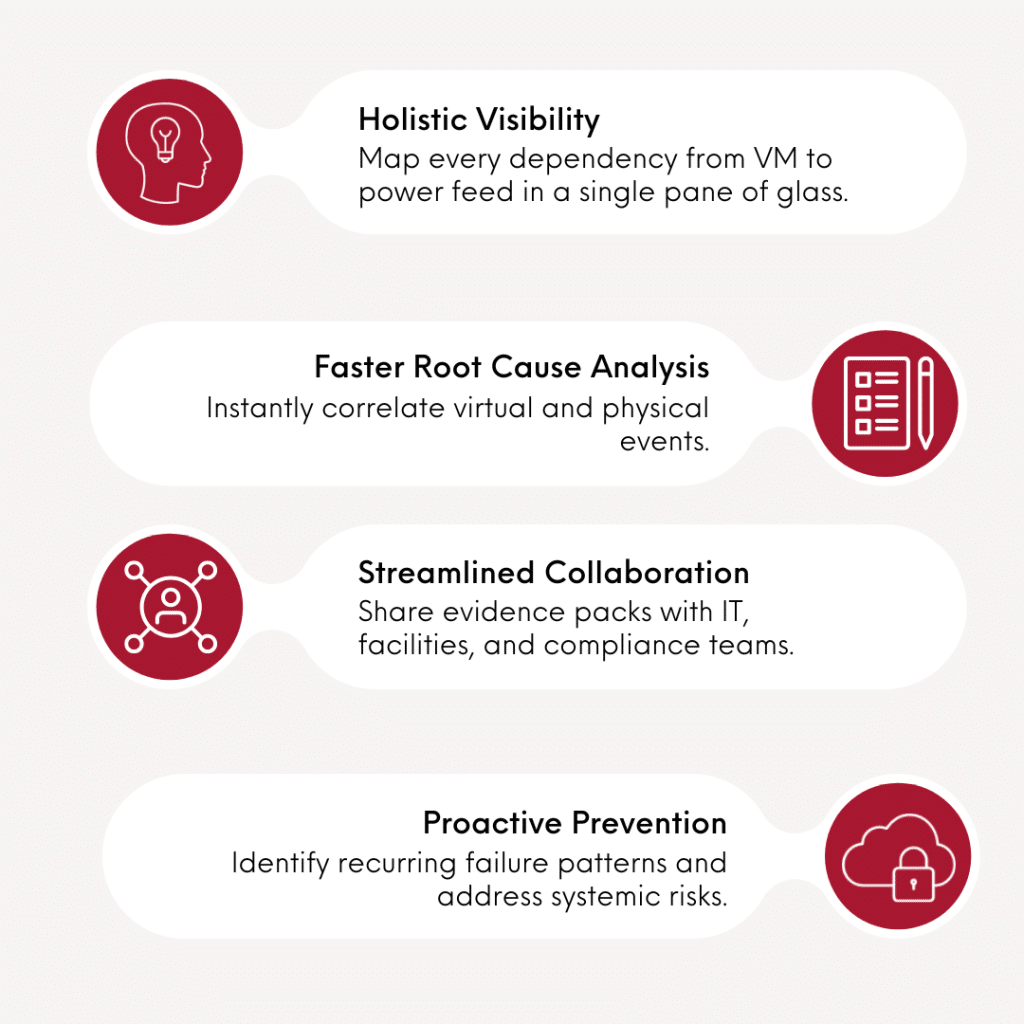
Gracias a esta integración, las organizaciones pueden identificar rápidamente las causas raíz, reducir el tiempo de inactividad y mejorar el tiempo medio de reparación (MTTR). Además, permite una planificación proactiva, una mejor asignación de recursos y una mayor resiliencia ante fallos en cascada.
Un escenario realista de interrupción del servicio de VMware
Imagina que una aplicación empresarial crítica se desconecta repentinamente. La investigación inicial apunta a un fallo de la máquina virtual, pero la causa raíz no está clara de inmediato. ¿Fue un problema del host? ¿Un fallo en la alimentación eléctrica del rack? ¿O algo en algún punto anterior de la cadena de alimentación?
Paso 1: Mapear la máquina virtual
Comience con la capa virtual. Identifique la máquina virtual afectada de inmediato. La integración de Nlyte ofrece visibilidad instantánea de la ubicación de las máquinas virtuales y sus relaciones. Este mapeo de dependencias garantiza que los equipos sepan exactamente dónde comienza el problema.
Paso 2: Identificar al huésped.
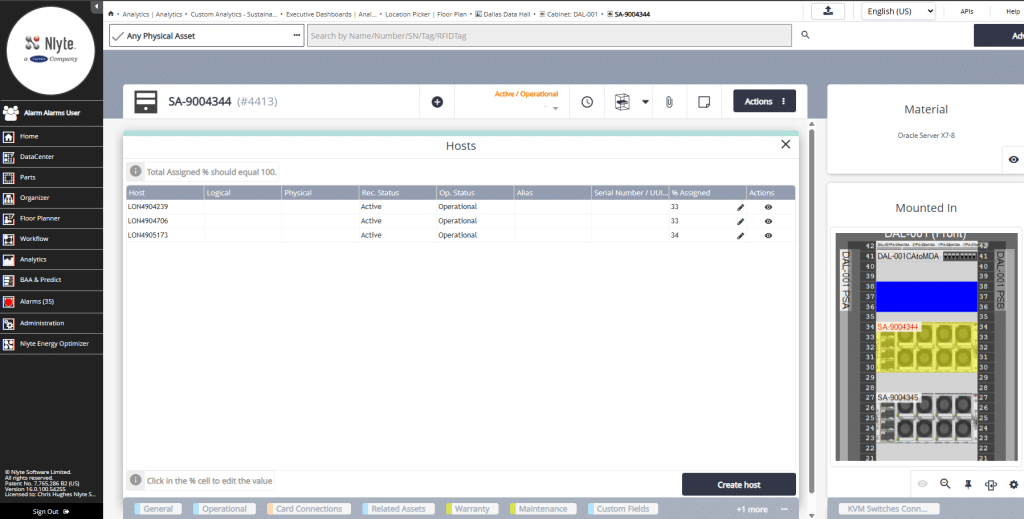
A continuación, rastrea la máquina virtual hasta su host ESXi. Comprender este vínculo es fundamental, ya que las fallas del host suelen afectar a varias máquinas virtuales. Una identificación rápida acelera la resolución de problemas y mantiene bajo el tiempo medio de reparación (MTTR).
Paso 3: Localiza el estante
Tras localizar el host, acceda a la capa física. La plataforma DCIM de Nlyte identifica con precisión el rack donde se encuentra el host. Este paso ayuda a determinar si la interrupción es un problema aislado o forma parte de un problema de infraestructura mayor.
Paso 4: Localice la PDU
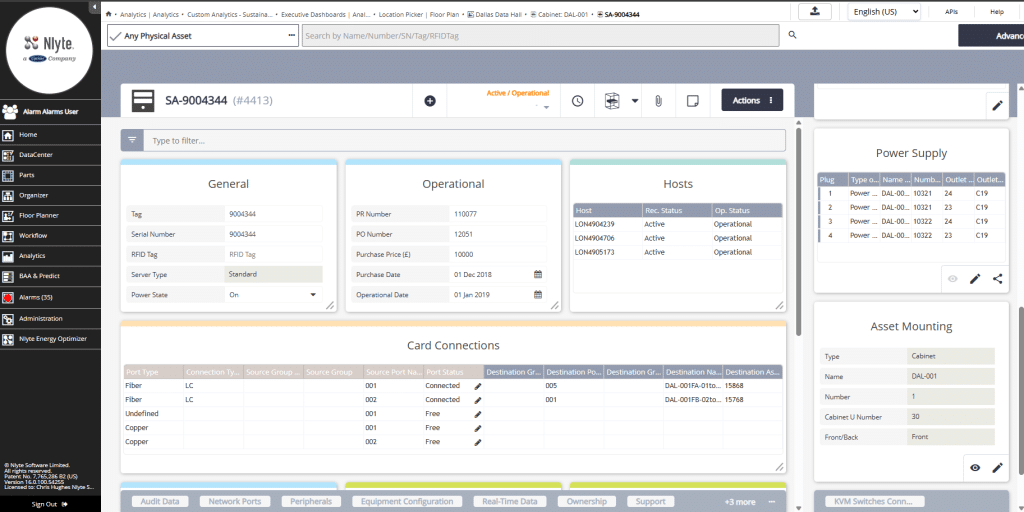
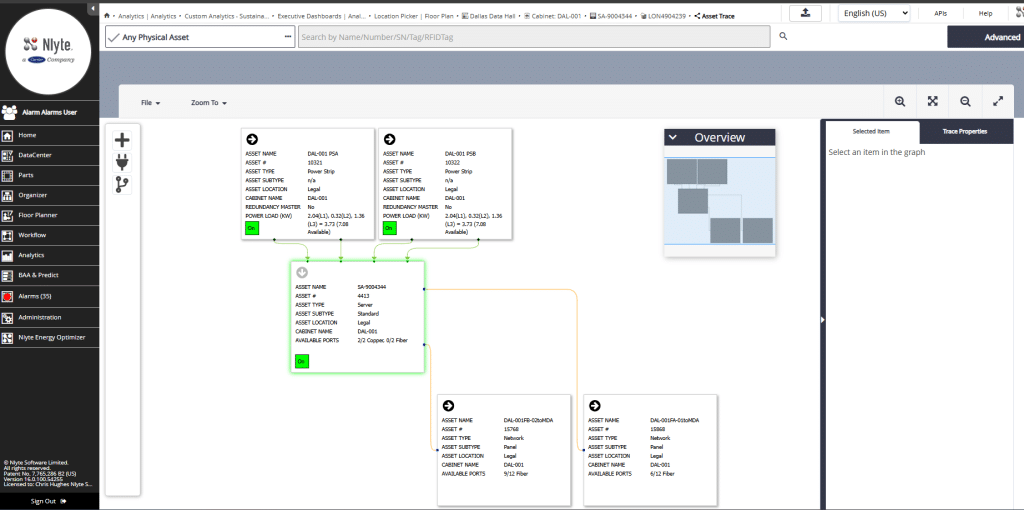
Desde el rack, siga el trazado hasta la Unidad de Distribución de Energía (PDU) conectada. Este mapeo es esencial para evaluar las dependencias de energía e identificar posibles riesgos de hardware.
Paso 5: Analizar la cadena de poder
Finalmente, analice en profundidad toda la cadena de suministro eléctrico. Nlyte proporciona monitorización en tiempo real y telemetría histórica para las PDU y las alimentaciones de la red. Si se produce un disparo del interruptor o una anomalía de voltaje, se correlaciona instantáneamente con la máquina virtual y el host afectados. Esta visión integral permite identificar las causas raíz y mejora la precisión del análisis posterior a la interrupción del servicio.
Por qué el mapeo de dependencias acelera el MTTR
Pruebe la demostración de mapeo de dependencias.
¿Listo para ver cómo la integración de Nlyte con VMware DCIM puede transformar su respuesta ante interrupciones del servicio?
Da el siguiente paso hacia un análisis más rápido de la causa raíz y una reducción del tiempo medio de reparación.
Solicite hoy mismo una demostración con uno de los expertos de Nlyte para recibir una demostración personalizada en vivo y descubrir cómo el mapeo avanzado de dependencias y la visibilidad de la cadena de suministro eléctrico pueden optimizar las operaciones de su centro de datos. > Solicitar una demostración | Nlyte
